Сформулируй тот же запрос чуть иначе, и языковая модель ответит совершенно по-другому. По словам команды проекта QuantPi, это самая распространённая проблема, которая обнаруживается при тестировании генеративного искусственного интеллекта. Исследователи создали платформу, которая сама создаёт тесты, выявляет нестабильность и предвзятость и готовит документацию для аудиторов. Они опробовали её и на системе, рекомендующей кандидатов на работу, — а в конце ты можешь проверить, насколько доверяешь ответам ИИ.
Генеративный искусственный интеллект всё чаще помогает оценивать кандидатов на работу, обслуживать клиентов и поддерживать бизнес-решения. Его главная сила — скорость. Но у него есть слабость, которую легко упустить из виду: он может совершенно по-разному реагировать на небольшое изменение в формулировке вопроса, языке или контексте. Для компаний это означает двойную задачу. Им нужно выявлять такие аномалии, а также иметь документацию, подтверждающую, что риск проверен и находится под контролем.
Проект QuantPi, поддержанный Европейским советом по инновациям, взялся за эту проблему. Он создал платформу для управления рисками генеративного искусственного интеллекта на основе технологии PiCrystal. Инструмент автоматически создаёт наборы тестов, проверяет поведение модели и превращает результаты в документацию, готовую к аудиту и связанную с требованиями Акта Европейского союза об искусственном интеллекте. Платформа изучает системы с трёх сторон: нестабильные результаты, предвзятость и наличие доказательств, которые можно представить при аудите.
Что чаще всего обнаруживается в таких тестах? Лукас Бирингер (Lukas Bieringer), руководитель направления политики и грантов в QuantPi, отвечает без обиняков: «Как правило, это непоследовательное или нестабильное поведение при реалистичных изменениях входных данных — один и тот же класс промптов даёт существенно разные результаты в зависимости от формулировки, языка или контекста».
На практике система может легко пройти простой бенчмарк, а затем дать сбой при встрече с настоящими пользователями, которые формулируют свои запросы по-своему. Только тогда выходят наружу предвзятость и неравенство между группами — различия, не видимые в средних результатах.
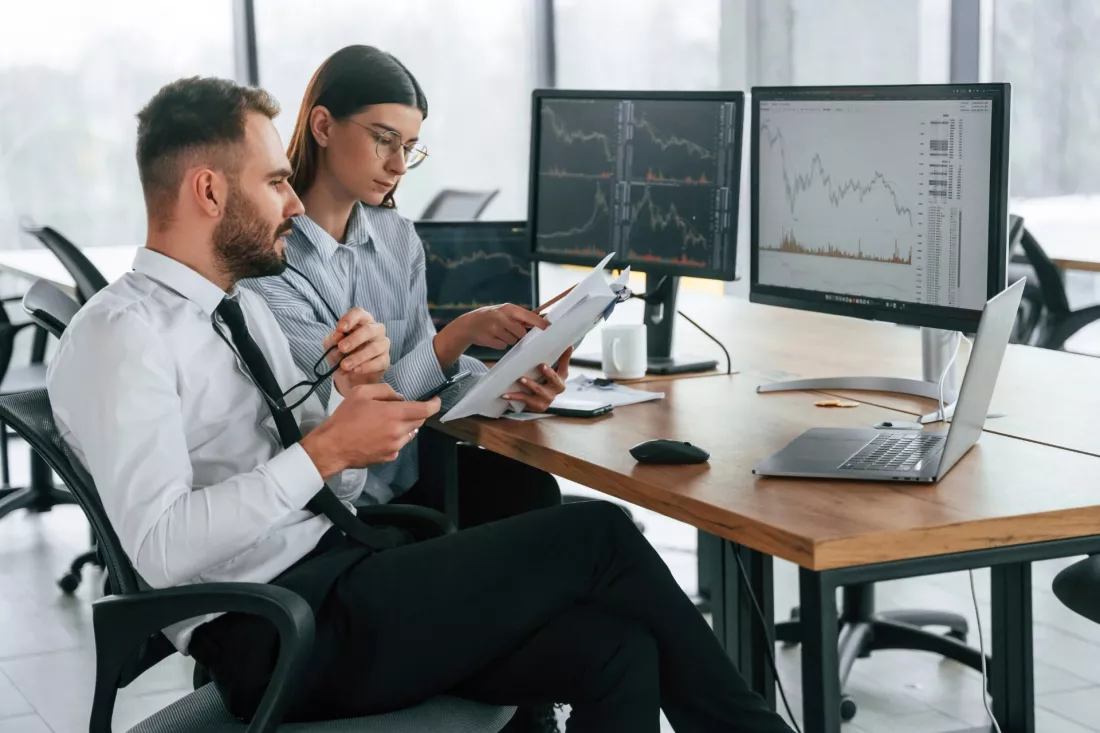
Команда проверила это на конкретном примере. Оценивалась система рекомендации кандидатов на основе большой языковой модели, партнёрами выступили рекрутинговая платформа Stepstone и лаборатория гарантии качества ИИ TÜV AI.Lab. Вывод важен для каждого, чьё резюме может попасть в такую систему. Тестирование инструментов ИИ, используемых при найме, требует больших и репрезентативных наборов данных. Только они позволяют провести интерсекциональное тестирование, при котором можно проверять пересекающиеся характеристики разных групп. Усреднение здесь работает как занавес: оно скрывает важные различия в том, как система обращается с отдельными сегментами.
Вторая идея QuantPi — отделить слой доказательств от слоя представления. Она вытекает из простого наблюдения: разным людям в компании нужна разная информация об одной и той же системе.
Чтобы эти взгляды не расходились, действует одно правило. Бирингер объясняет: «Ключевой принцип проектирования: все представления должны исходить из одной и той же статистической базы доказательств, чтобы утверждение на уровне совета директоров всегда можно было проследить до конкретного результата теста».
Автоматизация не означает, что человеческое суждение становится ненужным. Люди определяют, для чего предназначена система, выбирают, какие определения справедливости или безопасности применяются, устанавливают пороги приемлемости и решают, внедрять инструмент, отложить его или отозвать. Распределение ролей ясно: платформа измеряет риск, а ответственные люди решают, какой его уровень приемлем.
Однажды проведённого теста тоже не хватит навсегда. Мониторинг запускается всякий раз, когда меняется ситуация: после обновления модели, пересмотренного промпта или нового поискового индекса. Дрейф входных данных, дрейф результатов и изменения в правилах тоже требуют повторной оценки, ведь любое из этого может обесценить прежние результаты.
По словам Бирингера, для многих компаний самое большое препятствие — уже не знание правил. Он говорит об этом прямо: «Чего они не могут, так это предоставить технические доказательства соответствия, которые выдержат проверку нотифицированного органа или аудитора, — особенно для генеративных систем, где традиционные отчёты по бенчмаркам недостаточны, а гармонизированных стандартов до сих пор нет». Платформа QuantPi призвана заполнить именно этот пробел, превращая технические тесты в доказательства, которыми разные команды могут пользоваться до и после внедрения.
Генеративный ИИ может быть капризным: тот же вопрос, заданный другими словами, способен дать совершенно другой ответ, а средние результаты тестов могут скрывать неравное отношение к отдельным группам. Проект QuantPi показывает, что для основательной оценки таких систем нужны автоматизированные, повторяемые тесты, репрезентативные данные и единая база доказательств для всех, от аналитика до совета директоров. Последнее слово о том, какой риск приемлем, однако по-прежнему остаётся за людьми.
5 вопросов · одна минута


 English
 Čeština
 Deutsch
 Español
 Français
 Magyar
 Italiano
 Polski
 Português
 Русский
 Slovenčina
 Türkçe
 Українська
 العربية
 中文