Menschen spüren meist, wenn sie unbekanntes Terrain betreten und ihr Wissen nicht mehr ausreicht. Künstliche Intelligenz hat dieses Gespür nicht: Sie lernt anhand ausgewählter Daten und ist oft ratlos, wenn die Welt anders aussieht als im Training. Das europäische Projekt E-pi brachte Algorithmen bei, ihr eigenes Nichtwissen zu erkennen, und erprobte das dort, wo ein Fehler am teuersten werden kann: bei autonomen Fahrzeugen. Am Ende kannst du prüfen, wie du selbst mit Unsicherheit umgehst.
Künstliche Intelligenz ist heute fast überall angekommen. Sie treibt die Wirtschaft an und verändert unsere Wohnungen, Schulen und Arbeitsplätze. Sie hat jedoch eine Schwachstelle, über die seltener gesprochen wird als über ihre Erfolge. Ein Modell lernt anhand eines bestimmten Datensatzes und muss danach in einer Welt funktionieren, die dem im Training Gesehenen nicht immer ähnelt. Genau dann beginnen die Probleme.
Diesem Problem widmete sich das von der Europäischen Union finanzierte Projekt E-pi, das von der Oxford Brookes University im Vereinigten Königreich koordiniert wurde. Sein Team arbeitete fünf Jahre lang an der sogenannten epistemischen künstlichen Intelligenz, also an einer KI, die besser mit Unsicherheit umgehen kann und auch in Situationen Vorhersagen treffen kann, die von den Trainingsdaten abweichen.
Das Wort epistemisch stammt von der Epistemologie, also dem Teilgebiet der Philosophie, das sich mit dem Wissen beschäftigt. Aus diesem Bereich stammt eine Fähigkeit, die für den Menschen völlig natürlich ist: zu bemerken, dass das, was wir wissen, in einer bestimmten Situation nicht ausreicht. Das ist einer der grundlegenden Bestandteile menschlicher Intelligenz.
Eine Maschine kann das von sich aus nicht. Bei ihr muss das Erkennen des eigenen Nichtwissens auf theoretischen und mathematischen Rahmenkonzepten aufbauen. Mit anderen Worten: Das Gefühl, hier nicht mehr sicher zu sein, muss dem Algorithmus buchstäblich in die Konstruktion geschrieben werden.
Projektkoordinator Fabio Cuzzolin weist darauf hin, dass klassische Algorithmen des maschinellen Lernens darauf ausgerichtet sind, einen relativ kleinen Trainingsdatensatz zu erklären, und nicht alle Daten, die in der Realität auftreten können. Die Folge ist leicht vorherzusehen. „Traditionelle KI-Modelle haben Schwierigkeiten damit, robuste Vorhersagen zu treffen, wenn sich die Wahrscheinlichkeitsverteilungen, aus denen die Daten stammen, von denen aus Trainingszeiten unterscheiden“, erklärt der Forscher.
Einfacher gesagt: Ein Modell, das nur einen Ausschnitt der Welt gut kennt, kann sich verirren, wenn es auf etwas außerhalb dieses Ausschnitts trifft. Das E-pi-Konsortium kam zu dem Schluss, dass die Theorie der Unsicherheit zweiter Ordnung das vielversprechendste Fundament für eine Lösung ist. Die Vorträge des Projekts fanden auf Fachkonferenzen großen Anklang, und Cuzzolin wurde gebeten, an mehreren damit verbundenen Horizont Europa-Vorschlägen mitzuwirken. Die Arbeit des Teams soll helfen, ein internationales Ökosystem epistemischer KI aufzubauen.
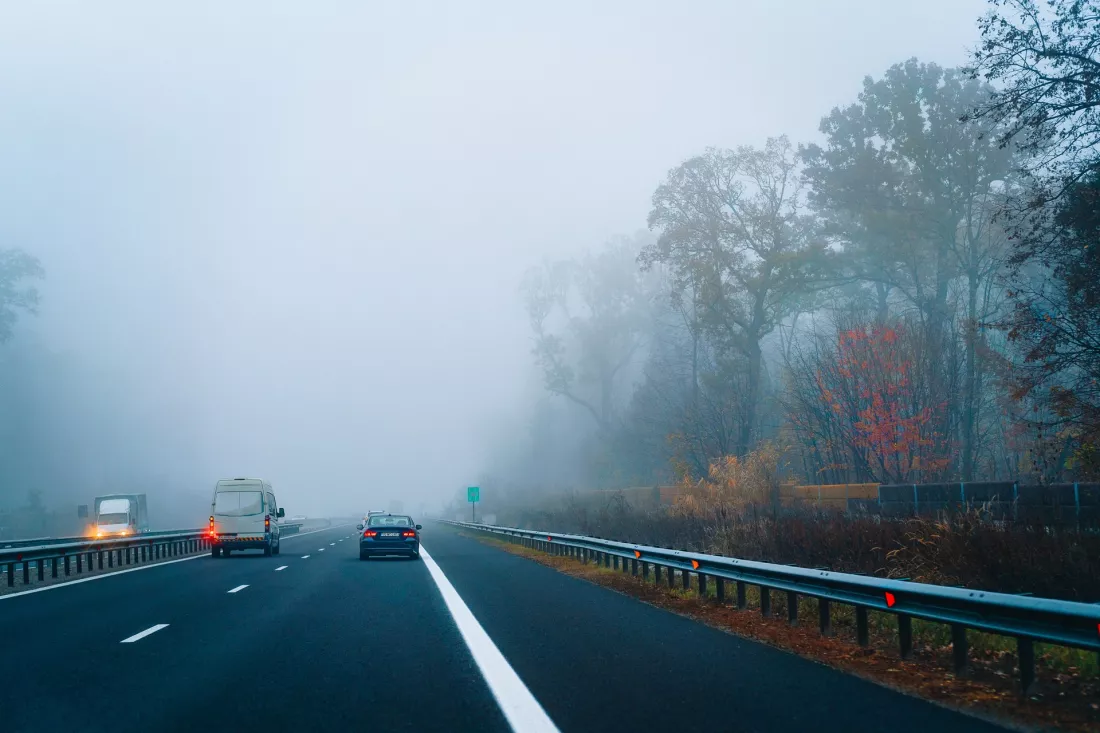
Wo lässt sich eine KI, die mit dem Unvorhersehbaren zurechtkommen soll, am besten erproben? Die Forschenden wählten autonome Fahrzeuge. Auf der Straße kann eine Situation plötzlich jedes Schema sprengen, etwa durch das Verhalten von Fußgängern, extremes Wetter oder eine ungewöhnliche Straßenführung. Fehler heutiger Systeme können kostspielig sein und im schlimmsten Fall tödliche Verletzungen zur Folge haben.
Das Team nutzte den Datensatz ROAD, der der Erkennung von Straßenereignissen durch autonome Fahrzeuge gewidmet ist. Er diente sowohl dem Training des Modells als auch der Erprobung neuer epistemischer Objektdetektoren. ROAD wird laufend erweitert und enthält Aufnahmen aus Europa, Nordamerika, Dubai und Abu Dhabi, wodurch er zu einer wahrhaft globalen Ressource geworden ist.
Sicherere Autos ohne Fahrer sind nur eines der Ziele. Von derselben Logik können auch andere Bereiche profitieren:
Die Kernfusion ist ein besonders anspruchsvolles Beispiel. „Wir arbeiten an der Entwicklung von unsicherheitsbewussten neuronalen Operatormodellen, um vorherzusagen, wie sich das Fusionsplasma in einem Tokamak ausbreiten wird und welche Bereiche des Reaktors davon stärker betroffen sein werden“, sagt Cuzzolin. Solche Modelle sollen den Plasmafluss im Inneren eines Tokamaks, also eines Reaktors, vorhersagen und anzeigen, welche seiner Bereiche am stärksten betroffen sein werden. Auch hier geht es um dasselbe: Ein Modell soll nicht nur ein Ergebnis liefern, sondern auch ehrlich berücksichtigen, wie sicher es sich dessen ist.
Eine weitere Richtung betrifft die generative KI. „Die derzeitigen, auf dem neuesten Stand der Technik befindlichen großen Sprachmodelle sind dafür bekannt, falsche Aussagen zu generieren“, räumt Cuzzolin ein. Seiner Ansicht nach könnten Modelle einen Ausweg bieten, die nach einem neuen Paradigma gebaut sind: „Epistemische große Sprachmodelle können die übermäßige Selbstsicherheit dieser Modelle erheblich mindern.“
Geplant sind außerdem Lösungen rund um die Theory of Mind sowie Systeme, die sich durch kontinuierliches Lernen weiterentwickeln. Der gemeinsame Nenner bleibt derselbe: Künstliche Intelligenz soll nicht nur antworten, sondern auch wissen, wann ihre Antwort auf wackligen Füßen steht.
Das Projekt E-pi, dessen Gesamtkosten bei etwa 3 Mio. Euro lagen, hat zur Entwicklung sichererer autonomer Fahrzeuge und Roboter sowie einer generativen künstlichen Intelligenz beigetragen, die nicht halluziniert. Außerdem hat es ein dynamisches Netzwerk von Fachleuten für maschinelles Lernen aufgebaut. Die Beteiligten sind überzeugt, dass epistemische KI die Welt und unseren Alltag verändern kann. Und alles beginnt mit einer sehr menschlichen Fähigkeit: zuzugeben, dass man etwas nicht weiß.
5 Fragen · eine Minute


 English
 Čeština
 Deutsch
 Español
 Français
 Magyar
 Italiano
 Polski
 Português
 Русский
 Slovenčina
 Türkçe
 Українська
 العربية
 中文